首页/HPC 网络解决方案/100/200G AI 存储网络方案

100/200G AI 存储网络方案

全面支持 RoCEv2,保障 GPU-Direct RDMA、Ceph 等相关流量无损传输

联系我们

100/200G AI 存储网络方案

SwitchInfra 100/200G AI 存储网络方案提供面向 AI 工作负载的无损、超低时延以太网。该方案基于具备深缓存和智能拥塞控制能力的 PicOS® 交换机,帮助消除导致 GPU 缺少数据供给的 I/O 瓶颈。方案全面支持 RoCEv2,并结合 PFC、ECN 和 DCQCN,确保 GPU-Direct RDMA、Ceph 及相关存储流量无损传输。标准以太网架构支持统一运维、平滑扩展,并相较专用互连降低 O&M 成本。
100/200G 低时延交换

PicOS® 交换机结合 PFC、ECN 和深缓存,为 AI 存储工作负载保持无损吞吐。基于硬件的流控可在微突发期间防止丢包,持续为 GPU 提供数据。

GPU-Direct RDMA 支持

RoCEv2 与 DCQCN 支持 GPU-Direct RDMA,绕过 CPU 和系统内存以显著降低时延,并加速 Ceph 分布式存储访问与 NCCL 集合通信。

统一以太网 Fabric

标准以太网架构减少厂商绑定、简化运维并降低总体拥有成本。AmpCon-DC 统一管理为计算与存储网络提供端到端可视化。

为什么选择 SwitchInfra AI 存储网络方案

无损 RoCEv2

DCQCN、PFC 和 ECN 协同消除丢包。共享缓存架构可吸收微突发,避免 AI 存储流量中的丢包和重传。

深缓存

充足的片上缓存容量可处理分布式 AI 训练典型的突发同步 I/O 模式,避免存储汇聚层出现 incast 拥塞崩溃。

智能负载均衡

DLB 和基于 flowlet 的哈希可将存储流量均匀分布到所有可用链路,避免热点并最大化并行文件系统访问的双向带宽。

遥测驱动运维

AmpCon-DC 提供 PFC 计数器、ECN 标记和缓存利用率的实时可视化。主动拥塞告警帮助运维人员在作业性能下降前介入。

方案架构

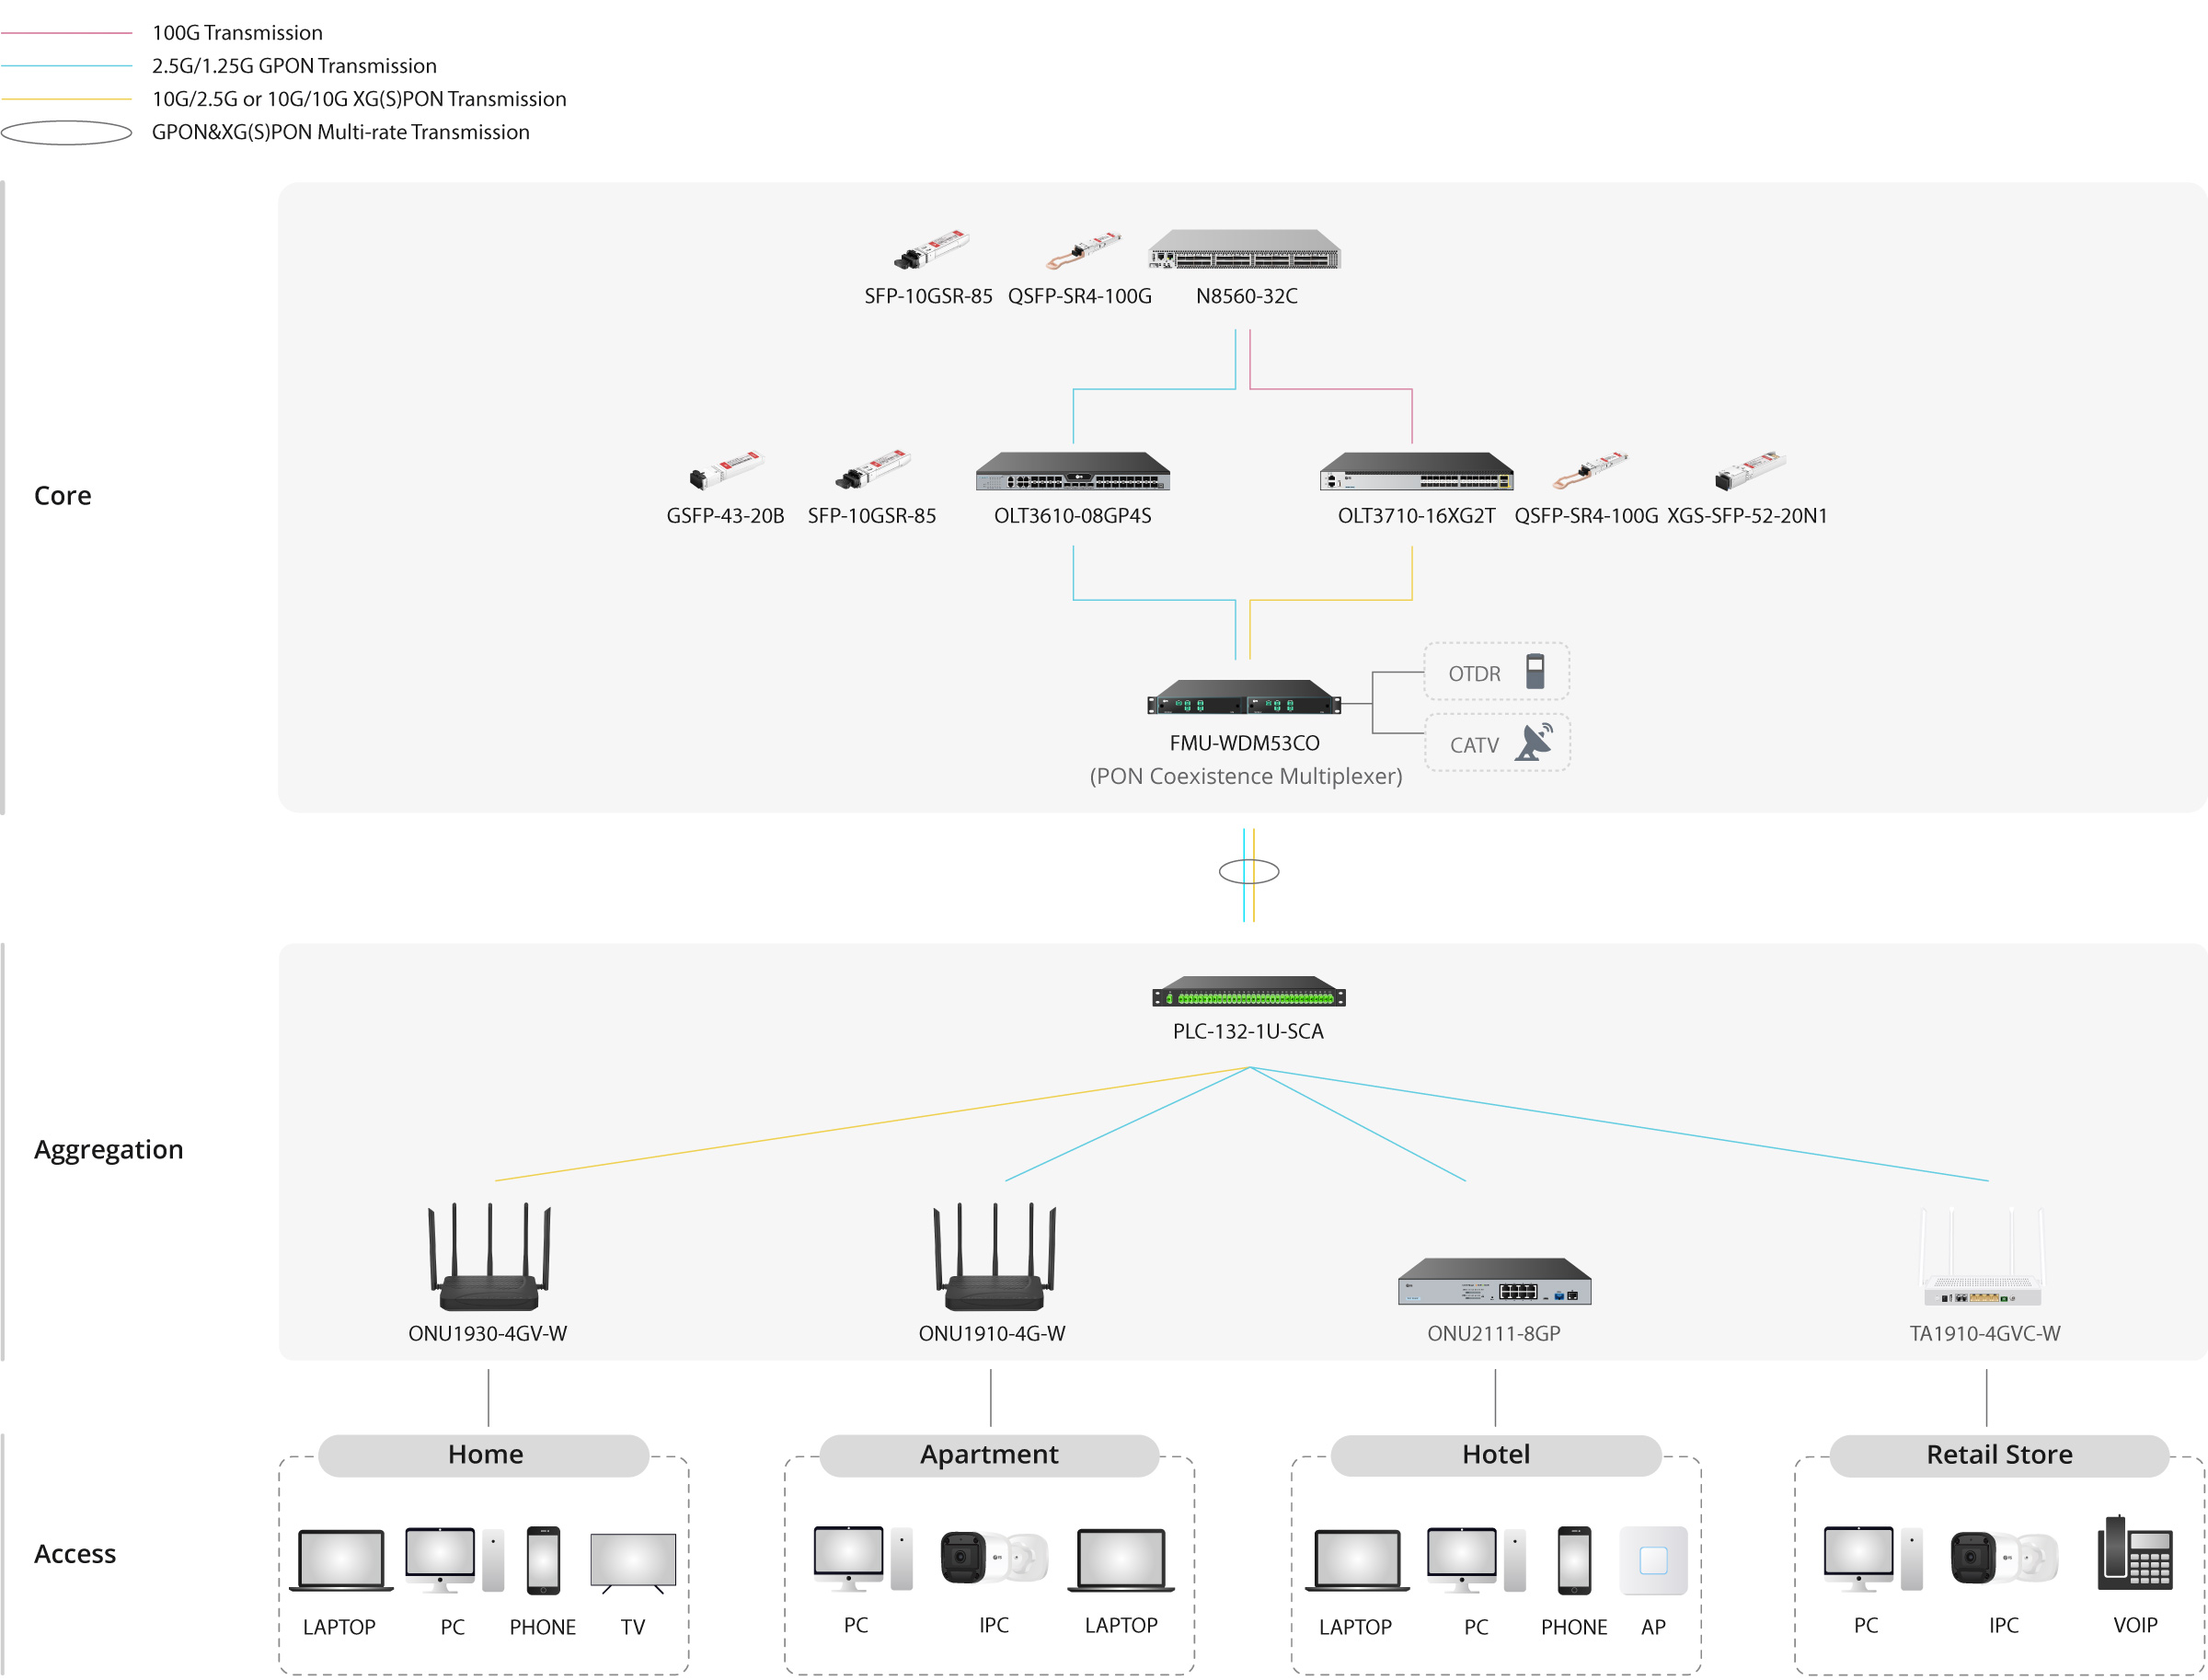
AI 存储网络采用面向东西向存储流量优化的两层 Spine-Leaf 架构。Storage Leaf 交换机通过 100G/200G 链路直连 GPU 服务器,Spine 交换机在各存储 Leaf 与并行文件系统之间提供无阻塞互联。RDMA over Converged Ethernet(RoCEv2)端到端运行,PFC 提供无损以太网传输,ECN 在队列溢出前标记拥塞。

Storage Leaf 层

100G/200G PicOS® 交换机通过深缓存直连 GPU 服务器。PFC 确保 RoCEv2 无损传输,每个 Leaf 可支持 32-64 个服务器端口,适合高密度 AI 集群。

Storage Spine 层

无阻塞 Spine 交换机通过 100G/200G 上联互连所有存储 Leaf。DLB 将流量分布到所有可用路径,最大化并行文件系统工作负载吞吐。

管理平面

AmpCon-DC 自动化交换机配置,并持续监控 PFC 计数器、ECN 标记和缓存利用率。REST API 可与现有 DCIM/ITSM 工具集成,实现统一运维。

联系我们

准备消除 AI 存储瓶颈?

SwitchInfra 100/200G AI 存储网络方案全面支持 RoCEv2,保障 GPU-Direct RDMA、Ceph 等相关流量无损传输。联系 HPC 专家,获取定制化设计。

+86 132 6592 2480

专家客户服务,5x24 电话支持

[email protected]
0/5000