独立 B2B 选型采购信息
按网络架构采购 AI 与 HPC 互联组件
SwitchInfra 为 Ethernet、RoCE 和 InfiniBand 项目的产品发现与询价准备整理交换机、光模块、网卡以及光纤或铜缆产品。
NVIDIA 和 Mellanox 名称仅用于描述采购者指定的平台系列,不代表官方关联或兼容性。准确 OPN 或 SKU、平台、软件或固件、拓扑、库存、交期、质保和条款必须在技术审核与询价中确认。
询价前需要比较
- Ethernet、RoCE 或 InfiniBand 架构与拓扑
- 速率、封装、距离、连接器和线缆类型
- 交换机与主机适配器平台及准确料号
- 软件或固件、FEC、分拆和部署约束
AI 网络选型采购需求应注明什么?
应注明网络架构、拓扑、交换机与主机适配器标识、端口与速率、光模块或线缆距离、连接器、软件或固件条件、数量和部署计划。
SwitchInfra 能仅根据本页确认 NVIDIA 或 Mellanox 兼容性吗?
不能。这些名称仅标识采购者指定的平台系列;兼容性必须结合准确 OPN 或 SKU、平台、软件或固件、拓扑和链路组件核验。
面向 B300 AI 集群的 51.2T 以太网 Fabric 方案
SwitchInfra 51.2T 以太网 Fabric 方案专为 NVIDIA B300 GPU 集群设计,基于 RoCEv2 无损网络提供 800G 端到端连接能力。双平面架构提升可扩展性、可靠性和 GPU 通信效率。独立 RDMA 存储网络隔离存储与计算流量,降低 CPU 开销并加速 AI 训练。方案基于 Tomahawk 5 芯片与 PicOS®,单机提供 51.2Tbps 交换容量,并通过智能拥塞控制、深缓存和硬件加速负载均衡减少大规模 AI 训练中的网络瓶颈。
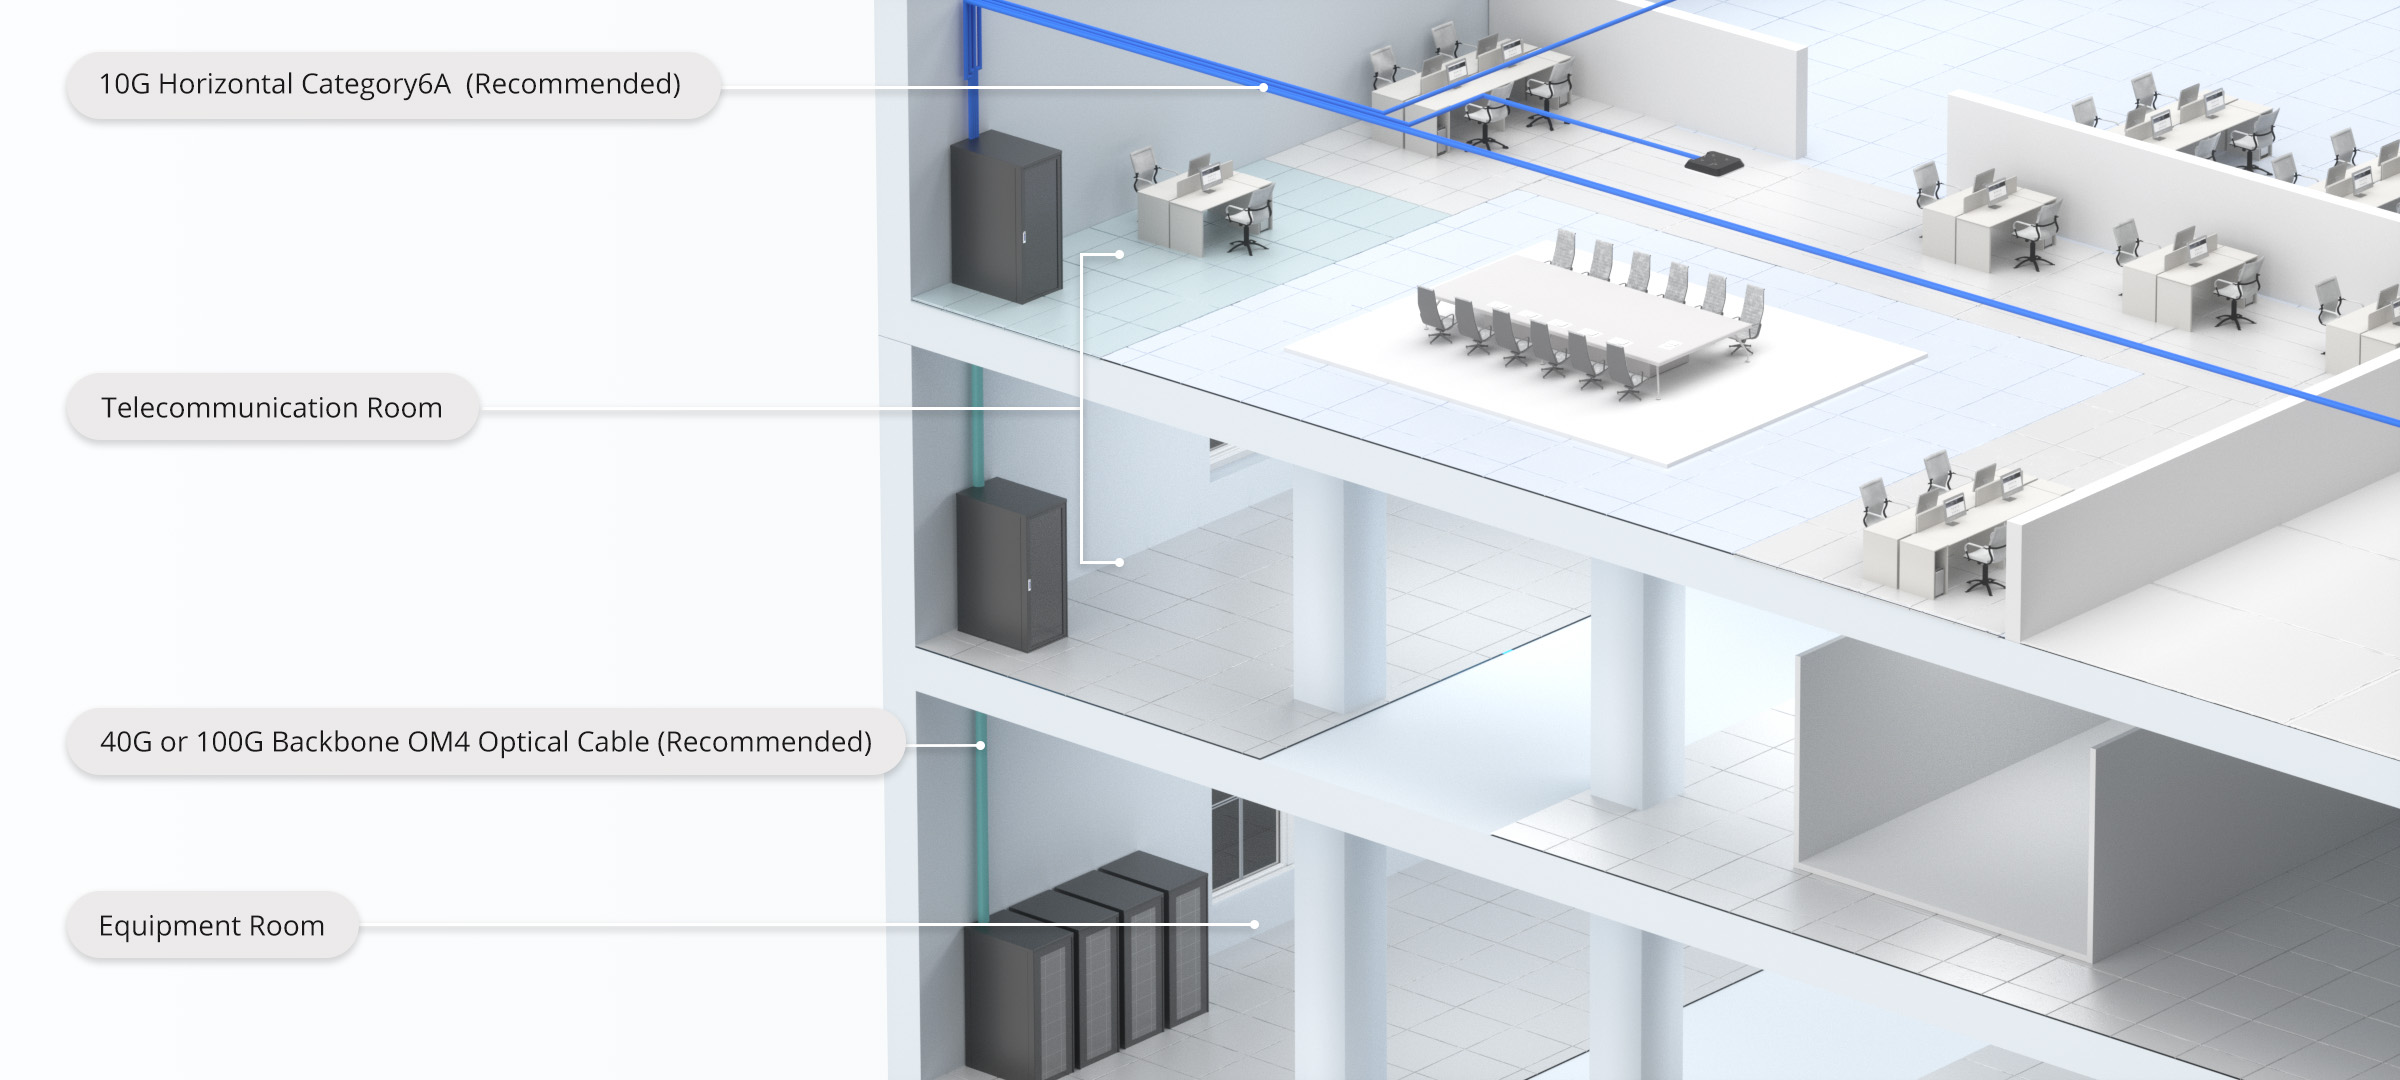
核心优势
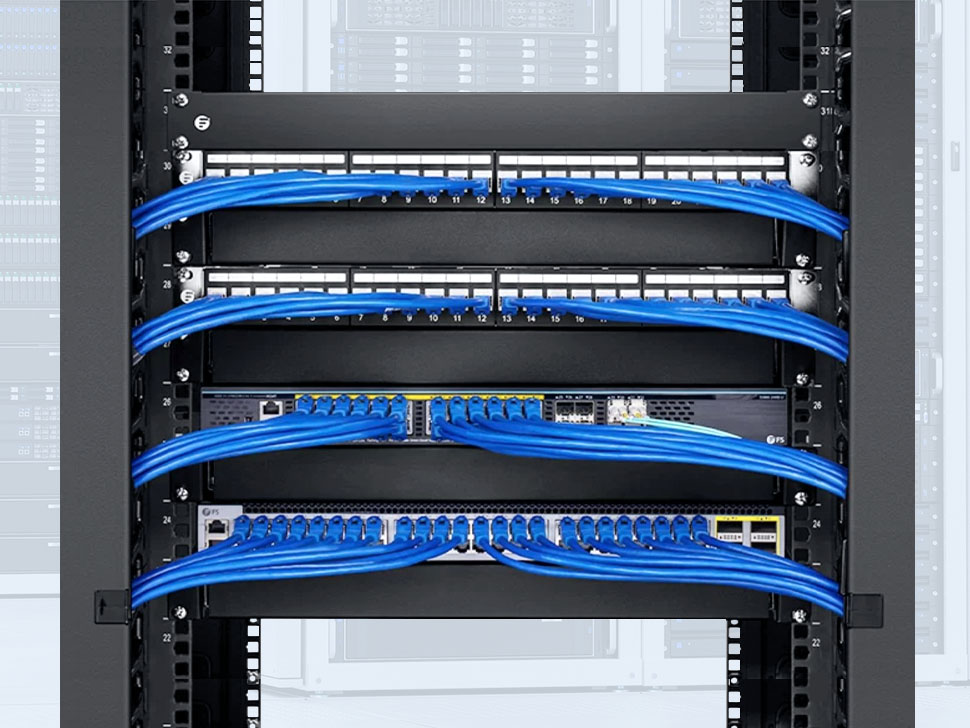
方案架构
51.2T 以太网 Fabric 采用双平面 Spine-Leaf 设计。计算平面通过无损 RoCEv2 承载 GPU 东西向通信,存储平面隔离 RDMA 存储流量,管理平面通过 AmpCon-DC 自动化部署和监控。
资源
联系我们
准备扩展 B300 AI 集群?
SwitchInfra 51.2T 以太网 Fabric 通过双平面架构提供 800G 无损 RoCEv2,最大化 GPU 利用率。联系 HPC 架构师,获取定制设计。